Tutoriales
Los rastreadores de IA explicados: GPTBot, ClaudeBot y robots.txt
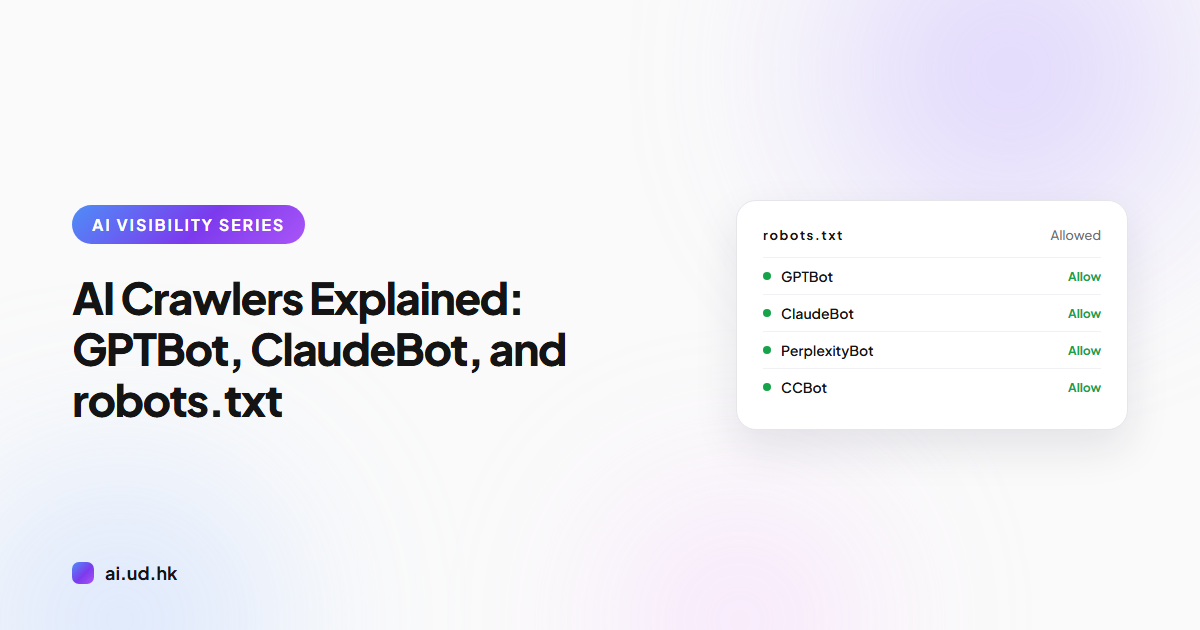
Conozca GPTBot, ClaudeBot y otros rastreadores de IA: qué recopilan, cómo darles la bienvenida en robots.txt y cómo detectar bloqueos del CDN en los registros del servidor.
Los rastreadores de IA son programas automatizados que OpenAI, Anthropic y otras empresas de IA utilizan para descargar el contenido público de su sitio web. Sus visitas tienen dos finalidades: recopilar datos de entrenamiento para los modelos de IA y recuperar páginas en tiempo real cuando un usuario formula una pregunta. Esta guía repasa la lista de rastreadores documentados, cómo redactar un robots.txt que les dé la bienvenida, cómo localizar bloqueos accidentales y cómo confirmar sus visitas en los registros del servidor.
Los principales rastreadores de IA: quién visita su sitio
Los rastreadores de IA descargan contenido web que después se incorpora a los datos de entrenamiento de los grandes modelos de lenguaje o se cita en tiempo real cuando un motor de IA responde a una pregunta. Estos son los nombres principales recogidos en la documentación pública:
- GPTBot: operado por OpenAI, descarga contenido web público para el entrenamiento de modelos.
- ClaudeBot: operado por Anthropic, recopila datos de entrenamiento para la familia de modelos Claude.
- PerplexityBot: operado por Perplexity, construye el índice que sustenta su buscador con IA.
- Google-Extended: es un identificador de control de robots.txt de Google, no un rastreador. Determina si su contenido puede usarse para el entrenamiento de IA, mientras que la descarga real la sigue haciendo Googlebot.
- CCBot: el rastreador de Common Crawl, que construye un archivo público de la web. Muchos modelos de IA toman datos de entrenamiento de ese archivo.
Cada rastreador se identifica en la cabecera User-Agent de sus peticiones. Esa cabecera es la que permite reconocerlos.
Entrenamiento frente a recuperación en directo: dos finalidades, dos consecuencias
Los rastreadores de entrenamiento incorporan su contenido a los datos de entrenamiento, que determinan lo que sabrán los modelos futuros. Si su marca y sus conocimientos aparecen en esos datos, es más probable que el modelo le mencione al responder más adelante a preguntas relacionadas.
Los rastreadores de recuperación en directo descargan las páginas en el momento en que el usuario formula la pregunta. El motor de IA cita el contenido directamente y a menudo adjunta un enlace a la fuente, de modo que el efecto es una exposición inmediata, más parecida a la de la búsqueda tradicional.
OpenAI ilustra bien por qué importa esta distinción. Documenta tres rastreadores independientes: GPTBot para el entrenamiento de modelos, OAI-SearchBot para la búsqueda de ChatGPT y ChatGPT-User para la navegación en directo por encargo del usuario, y cada uno se controla por separado en robots.txt. Bloquear GPTBot no retira su sitio de la búsqueda de ChatGPT.
Las consecuencias del bloqueo varían según el tipo. Bloquear los rastreadores de entrenamiento supone una ausencia a largo plazo de aquello que los modelos saben. Bloquear los de recuperación supone la invisibilidad inmediata en la búsqueda con IA, así que conviene identificar con qué tipo se está tratando antes de decidir.
Cómo redactar un robots.txt que dé la bienvenida en lugar de bloquear
La lógica por defecto de robots.txt es sencilla: todo lo que no tenga una regla Disallow está permitido. Para dar la bienvenida a los rastreadores de IA de forma explícita, indíquelos por su nombre:
User-agent: GPTBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: PerplexityBot
Allow: /
Un Allow explícito cumple dos funciones. Declara una postura abierta y mantiene a estos rastreadores fuera del alcance de cualquier regla Disallow general. El error autoinfligido más habitual es User-agent: * combinado con Disallow: /, que deja fuera a todos los rastreadores, incluidos los de IA.
También puede añadir un archivo llms.txt en el directorio raíz del sitio. llms.txt es una propuesta de archivo de texto plano que resume en Markdown los contenidos clave del sitio para los grandes modelos de lenguaje, y complementa a robots.txt en lugar de sustituirlo.
Cortafuegos y CDN: los bloqueos accidentales más habituales
Un robots.txt acogedor no sirve de nada si las peticiones se detienen en la capa del cortafuegos, porque el rastreador nunca llega a leer el contenido. Este es el fallo más frecuente y también el más invisible.
Las funciones de gestión de bots de los WAF y los CDN tratan con frecuencia a los rastreadores de IA como tráfico malicioso y devuelven errores 403 o páginas CAPTCHA. Algunos proveedores de CDN incluso activan el bloqueo de rastreadores de IA por defecto, de modo que el propietario del sitio puede llevar meses bloqueándolos sin saberlo.
Hay tres puntos que revisar. Compruebe los ajustes de gestión de bots del CDN o del cortafuegos, busque reglas de bloqueo dirigidas a cadenas User-Agent y confirme que la limitación de peticiones no está interpretando un rastreo normal como un ataque. Cuando haga falta, añada los rastreadores de IA conocidos a una lista de permitidos.
Cómo confirmar las visitas de rastreadores de IA en los registros del servidor
El método más directo consiste en buscar en los registros de acceso del servidor las cadenas User-Agent de los rastreadores, como GPTBot, ClaudeBot, PerplexityBot y CCBot. Cuando encuentre entradas, revise dos cosas.
Primero, los códigos de estado. Un 200 significa que el contenido se leyó correctamente, un 403 que la petición fue bloqueada y un 404 que la ruta no existe. Una gran cantidad de 403 es una prueba directa de bloqueo accidental.
Segundo, la autenticidad. Las cadenas User-Agent pueden falsificarse, por lo que algunas empresas publican los rangos de IP oficiales de sus rastreadores; también se puede verificar el origen con una consulta DNS inversa. Tenga en cuenta que, si hay un CDN delante del sitio, las peticiones que este bloquea nunca llegan a los registros del servidor de origen, así que revise los registros o el panel de analítica del propio CDN.
Preguntas frecuentes
¿Qué es GPTBot?
GPTBot es el rastreador web de OpenAI. Descarga contenido web público para el entrenamiento de modelos de IA y se puede controlar desde robots.txt.
¿Bloquear GPTBot retira mi sitio de la búsqueda de ChatGPT?
No. La búsqueda de ChatGPT depende de OAI-SearchBot, un rastreador distinto con sus propios controles en robots.txt. GPTBot rige únicamente los datos de entrenamiento.
¿Bloquear Google-Extended perjudica mi posicionamiento en Google Search?
No. Google-Extended solo regula el permiso para el entrenamiento de IA y funciona con independencia de la indexación y el posicionamiento de búsqueda de Googlebot.
¿Qué es llms.txt?
llms.txt es una propuesta de archivo de texto plano que se coloca en el directorio raíz de un sitio. Resume en Markdown los contenidos clave del sitio para que los modelos de IA los lean.
¿Cómo puedo confirmar si los rastreadores de IA han visitado mi sitio web?
Busque en los registros de acceso del servidor cadenas User-Agent como GPTBot y ClaudeBot y compruebe después si los códigos de estado son 200.
Compruebe si su sitio está abierto o cerrado a la IA
A estas alturas seguramente querrá saber en qué situación está su propio sitio: si robots.txt bloquea por accidente y si los rastreadores de IA pueden leer realmente su contenido. El AEO Auditor gratuito de UDomain (ai.ud.hk/aeo-auditor) revisa los ajustes de visibilidad en IA de su sitio y basta con introducir una URL para ver los resultados. AEO significa aquí Answer Engine Optimization, la práctica de facilitar que los buscadores con IA citen el contenido. No tiene nada que ver con el programa aduanero Authorized Economic Operator ni con el símbolo bursátil de nombre parecido.
Lecturas relacionadas
¿Quieres saber qué visibilidad tiene tu sitio en la IA?
Haz un análisis gratuito de 30 segundos y ve tu puntuación y recomendaciones al instante.
Análisis gratis