教学
AI 爬虫完整指南:GPTBot、ClaudeBot 来你网站做什么
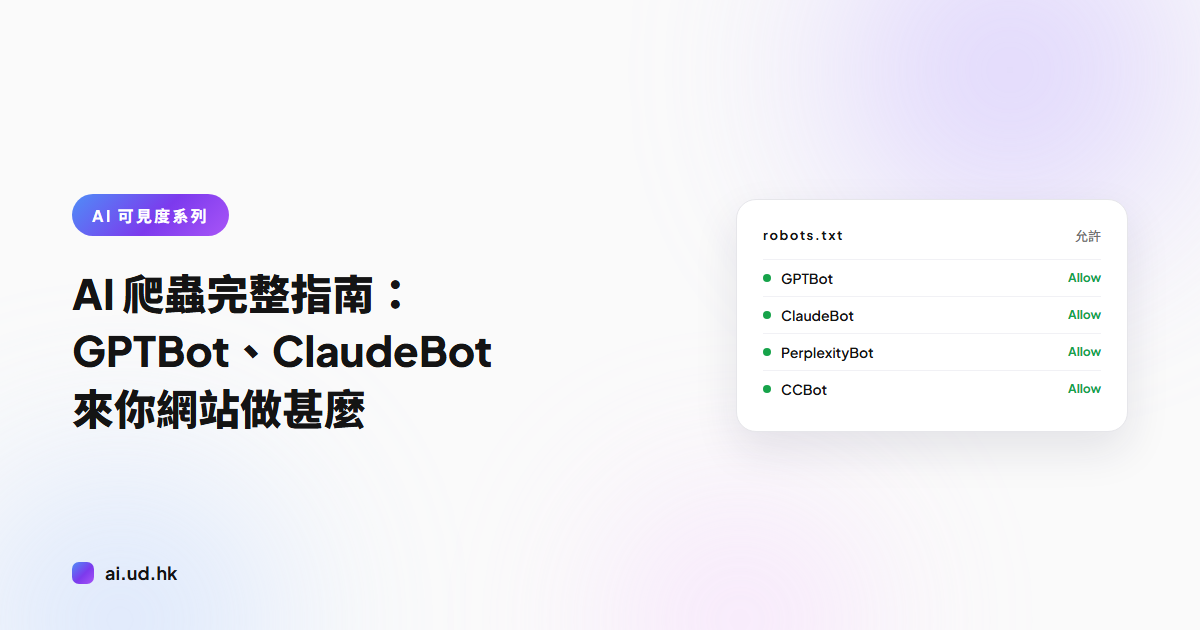
认识 GPTBot、ClaudeBot 等主流 AI 爬虫:抓什么、robots.txt 怎么写才算欢迎、CDN 误封与服务器日志核实方法。
AI 爬虫是 OpenAI、Anthropic 等公司的自动程序,会抓取你网站的公开内容,用途分为模型训练与实时检索两类。本文带你认识主流爬虫名单、写好 robots.txt、排查误封,并在服务器日志中确认它们来过。
主流 AI 爬虫名单:谁在爬你的网站
AI 爬虫是 AI 公司用来抓取网页内容的自动程序,抓到的内容会用于训练大语言模型,或在用户提问时用作实时检索与引用。以下是公开文档列明的主流名单:
- GPTBot:OpenAI 旗下,抓取公开网页内容用于模型训练。
- ClaudeBot:Anthropic 旗下,为 Claude 系列模型收集训练数据。
- PerplexityBot:Perplexity 旗下,为其 AI 搜索引擎建立索引。
- Google-Extended:Google 的 robots.txt 控制项,决定内容能否用于 AI 训练,实际抓取仍由 Googlebot 执行。
- CCBot:Common Crawl 的爬虫,建立公开网页存档,不少 AI 模型的训练数据都取自这个存档。
每个爬虫都会在请求的 User-Agent 头中表明身份,这正是你识别它们的入口。
训练与实时检索:两类用途,两种后果
训练型爬虫把内容收进训练数据,影响的是未来模型“知道什么”。你的品牌与专业内容如果出现在训练数据中,模型日后回答相关问题时更有机会提到你。
实时检索型爬虫在用户提问的当下抓取网页,AI 引擎会直接引用内容,并经常附上来源链接。这类抓取带来的是即时曝光,效果比较接近传统搜索。
封锁两类爬虫的后果不同:封训练型是长期缺席,封检索型是当场隐形。决定开放还是封锁之前,先分清楚对象属于哪一类。
robots.txt 怎么写才是欢迎而不是封锁
robots.txt 的默认逻辑是:没有写 Disallow 就等于允许。想明确欢迎 AI 爬虫,可以逐一列名:
User-agent: GPTBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: PerplexityBot
Allow: /
明确写 Allow 有两个作用:一是宣示开放立场,二是避免这些爬虫被笼统的 Disallow 规则扫到。最常见的自我封锁写法是 User-agent: * 配 Disallow: /,这会把所有爬虫连同 AI 爬虫一并拒之门外。
另外可以在网站根目录加一个 llms.txt。llms.txt 是一项纯文本文件建议规范,用 Markdown 整理网站重点内容供大语言模型读取,与 robots.txt 互补而非取代。
防火墙与 CDN 的常见误伤
robots.txt 写得再欢迎,如果请求在防火墙这一层就被挡下,爬虫根本读不到你的内容。这是最常见也最隐蔽的问题。
WAF 与 CDN 的机器人管理功能,经常把 AI 爬虫当成恶意流量,返回 403 错误或人机验证页。部分 CDN 服务商还把封锁 AI 爬虫设为默认选项,网站管理员未必知道自己一直在挡。
排查方向有三个:检查 CDN 或防火墙的机器人管理设置,查看有没有针对 User-Agent 的封锁规则,并确认速率限制不会把正常抓取当成攻击。有需要时,把已知的 AI 爬虫列入白名单。
如何从服务器日志确认 AI 爬虫来过
最直接的方法是在服务器访问日志中搜索爬虫的 User-Agent 字符串,例如 GPTBot、ClaudeBot、PerplexityBot、CCBot。找到记录后,再看两件事。
第一是状态码:200 代表成功读取,403 代表被挡,404 代表路径不存在。大量 403 就是误封的直接证据。
第二是真伪:User-Agent 可以伪造,部分公司公开了官方爬虫的 IP 范围供核对,也可以用反向 DNS 验证来源。另外要注意,如果网站前面有 CDN,被 CDN 挡下的请求不会出现在源服务器日志里,要到 CDN 的日志或分析面板查看。
常见问题
GPTBot 是什么?
GPTBot 是 OpenAI 的网页爬虫,抓取公开网页内容用于 AI 模型训练,可以在 robots.txt 中控制。
封锁 GPTBot 会让我的网站从 ChatGPT 搜索中消失吗?
不会。ChatGPT 搜索依赖 OAI-SearchBot,这是另一个有独立 robots.txt 控制规则的爬虫。GPTBot 只负责训练数据。
封锁 Google-Extended 会影响 Google 搜索排名吗?
不会。Google-Extended 只管 AI 训练授权,与 Googlebot 的搜索索引和排名相互独立。
llms.txt 是什么?
llms.txt 是放在网站根目录的纯文本文件建议规范,用 Markdown 整理网站重点内容供 AI 模型读取。
怎么确认 AI 爬虫有没有来过我的网站?
在服务器访问日志中搜索 GPTBot、ClaudeBot 等 User-Agent 字符串,并查看状态码是否为 200。
检查你的网站对 AI 是开门还是关门
读到这里,你大概想知道自己网站的现状:robots.txt 有没有误封,AI 爬虫能不能顺利读取内容。UDomain 的免费工具 AEO Auditor(ai.ud.hk/aeo-auditor)可以帮你检测网站的 AI 可见度设置,输入网址就能看到结果。这里的 AEO 指答案引擎优化(Answer Engine Optimization),与海关的认可经济营运商计划无关。