チュートリアル
AI クローラー入門:GPTBot、ClaudeBot と robots.txt
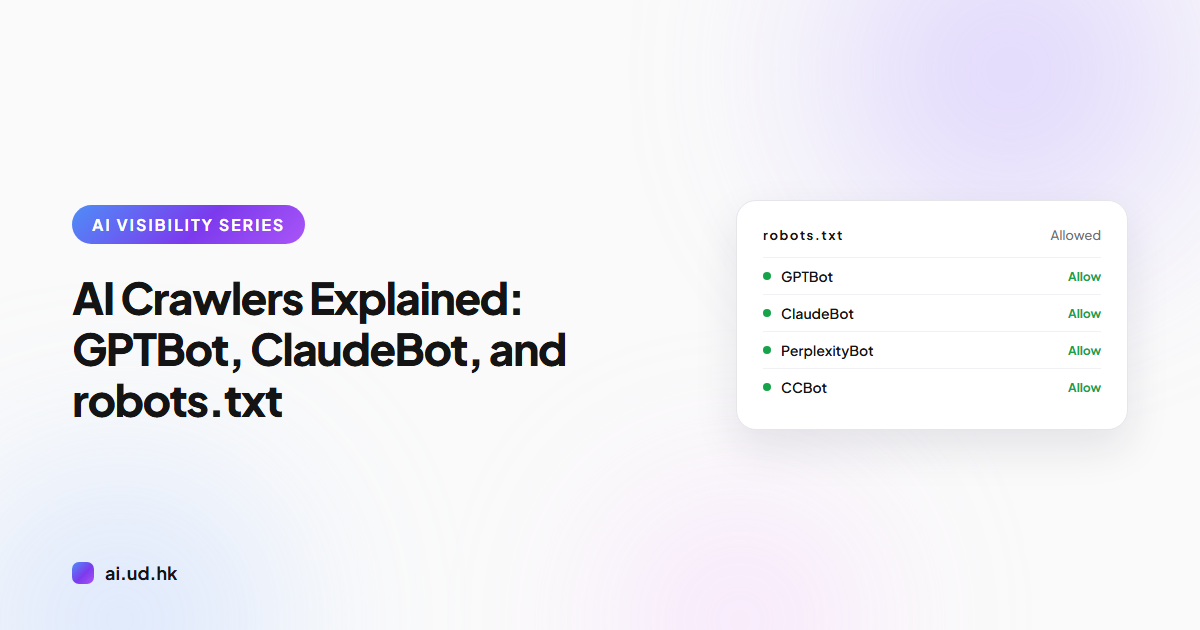
GPTBot や ClaudeBot などの AI クローラーが何を収集するのか、robots.txt でどう受け入れるのか、サーバーログから CDN のブロックをどう見つけるのかを解説します。
AI クローラーとは、OpenAI や Anthropic などの AI 企業が運用し、ウェブサイトの公開コンテンツを取得する自動プログラムです。その訪問には 2 つの目的があります。AI モデルの学習データを収集することと、ユーザーが質問した時点でページをリアルタイムに取得することです。本ガイドでは、公式に文書化されているクローラーの一覧、クローラーを受け入れる robots.txt の書き方、意図しないブロックの見つけ方、そしてサーバーログで訪問を確認する方法を解説します。
主要な AI クローラー:自社サイトに来ているのは誰か
AI クローラーが取得したウェブコンテンツは、大規模言語モデルの学習データに組み込まれるか、AI エンジンが質問に答える際にリアルタイムで引用されます。公式ドキュメントに記載されている主要なものは次のとおりです。
- GPTBot:OpenAI が運用し、モデルの学習用に公開ウェブコンテンツを取得します。
- ClaudeBot:Anthropic が運用し、Claude シリーズのモデル向けに学習データを収集します。
- PerplexityBot:Perplexity が運用し、同社の AI 検索エンジンを支えるインデックスを構築します。
- Google-Extended:Google が提供する robots.txt の制御トークンで、クローラーではありません。コンテンツを AI の学習に利用してよいかを決めるもので、実際の取得は引き続き Googlebot が行います。
- CCBot:Common Crawl のクローラーで、ウェブの公開アーカイブを構築します。多くの AI モデルがこのアーカイブから学習データを取得しています。
どのクローラーも、リクエストの User-Agent ヘッダーで自身を名乗ります。このヘッダーが識別の手がかりになります。
学習とリアルタイム取得:目的が 2 つ、影響も 2 つ
学習用のクローラーは、コンテンツを学習データに取り込み、将来のモデルが持つ知識を形づくります。自社のブランドや専門知識がそのデータに含まれていれば、モデルが関連する質問に答える際に自社に言及する可能性が高まります。
リアルタイム取得のクローラーは、ユーザーが質問した時点でページを取得します。AI エンジンはその内容を直接引用し、多くの場合は出典リンクも添えます。そのため効果はすぐに露出につながり、従来の検索に近い形になります。
この区別がなぜ重要なのかは、OpenAI の例が分かりやすいでしょう。同社は 3 つのクローラーを公表しています。モデル学習用の GPTBot、ChatGPT 検索用の OAI-SearchBot、ユーザーの代わりにリアルタイムで閲覧する ChatGPT-User で、robots.txt ではそれぞれ別に制御します。GPTBot をブロックしても、ChatGPT 検索からサイトが消えるわけではありません。
ブロックした場合の影響も、種類によって異なります。学習用のクローラーをブロックすれば、モデルが持つ知識から長期的に外れます。取得用のクローラーをブロックすれば、AI 検索ですぐに見えなくなります。判断する前に、どちらの種類を相手にしているのかを見極めてください。
ブロックせずに受け入れる robots.txt の書き方
robots.txt の既定の動作は単純です。Disallow のルールがなければ許可されます。AI クローラーを明示的に受け入れるには、名前を挙げて記述します。
User-agent: GPTBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: PerplexityBot
Allow: /
明示的な Allow には 2 つの意味があります。受け入れる姿勢を宣言することと、これらのクローラーを一括の Disallow ルールの影響から外すことです。最もよくある自滅は、User-agent: * と Disallow: / の組み合わせです。これはすべてのクローラーを遮断し、AI クローラーも例外ではありません。
サイトのルートディレクトリに llms.txt を追加することもできます。llms.txt は、サイトの主要コンテンツを Markdown で要約して大規模言語モデルに伝えるプレーンテキストファイルの提案仕様で、robots.txt を置き換えるのではなく補完します。
ファイアウォールと CDN:最もよくある意図しないブロック
robots.txt で受け入れていても、リクエストがファイアウォールの層で止められていれば意味がありません。クローラーはコンテンツを読む段階まで到達できないからです。これは最もよくあり、最も気づきにくい失敗です。
WAF や CDN のボット管理機能は、AI クローラーを悪意のあるトラフィックとして扱い、403 エラーや CAPTCHA ページを返すことがよくあります。AI クローラーのブロックを既定の設定として提供している CDN 事業者もあり、サイト運営者が気づかないまま何か月もブロックし続けているケースもあります。
確認すべき箇所は 3 つあります。CDN やファイアウォールのボット管理設定を見直すこと、User-Agent 文字列を対象にしたブロックルールを探すこと、そしてレート制限が通常のクロールを攻撃として扱っていないかを確かめることです。必要に応じて、既知の AI クローラーを許可リストに追加してください。
サーバーログで AI クローラーの訪問を確認する
最も直接的な方法は、サーバーのアクセスログを GPTBot、ClaudeBot、PerplexityBot、CCBot といったクローラーの User-Agent 文字列で検索することです。該当する記録が見つかったら、2 点を確認します。
1 つ目はステータスコードです。200 はコンテンツが正常に読み取られたこと、403 はリクエストがブロックされたこと、404 はそのパスが存在しないことを意味します。403 が大量に出ていれば、意図しないブロックの直接的な証拠です。
2 つ目は真正性です。User-Agent 文字列は偽装できるため、クローラーの公式 IP レンジを公開している企業もあり、逆引き DNS で送信元を検証することもできます。なお、サイトの前段に CDN がある場合、CDN がブロックしたリクエストはオリジンのログには届きません。その場合は CDN 自身のログや分析画面を確認してください。
よくある質問
GPTBot とは何ですか?
GPTBot は OpenAI のウェブクローラーです。AI モデルの学習用に公開ウェブコンテンツを取得し、robots.txt で制御できます。
GPTBot をブロックすると、ChatGPT 検索からサイトが消えますか?
消えません。ChatGPT 検索は OAI-SearchBot という別のクローラーを使っており、robots.txt でも個別に制御します。GPTBot が関係するのは学習データだけです。
Google-Extended をブロックすると、Google 検索の順位に悪影響がありますか?
影響ありません。Google-Extended が制御するのは AI 学習の許可だけで、Googlebot による検索のインデックスや順位付けとは独立して動作します。
llms.txt とは何ですか?
llms.txt は、サイトのルートディレクトリに置くプレーンテキストファイルの提案仕様です。サイトの主要コンテンツを Markdown で要約し、AI モデルが読めるようにします。
AI クローラーが自社サイトを訪問したかどうかは、どう確認しますか?
サーバーのアクセスログを GPTBot や ClaudeBot などの User-Agent 文字列で検索し、ステータスコードが 200 になっているかを確認します。
自社サイトが AI に開いているか閉じているかを確認する
ここまで読むと、自社サイトの現状が気になるはずです。robots.txt が誤ってブロックしていないか、AI クローラーが実際にコンテンツを読めているか。UDomain の無料ツール AEO Auditor(ai.ud.hk/aeo-auditor)は、サイトの AI 可視性の設定をチェックします。URL を入力するだけで結果が分かります。ここでいう AEO は Answer Engine Optimization の略で、AI 検索エンジンに引用されやすいコンテンツにするための取り組みを指します。税関の Authorized Economic Operator 制度や、同じ略称の株式ティッカーとは関係ありません。