Tutoriels
Les robots d'indexation d'IA expliqués : GPTBot, ClaudeBot et robots.txt
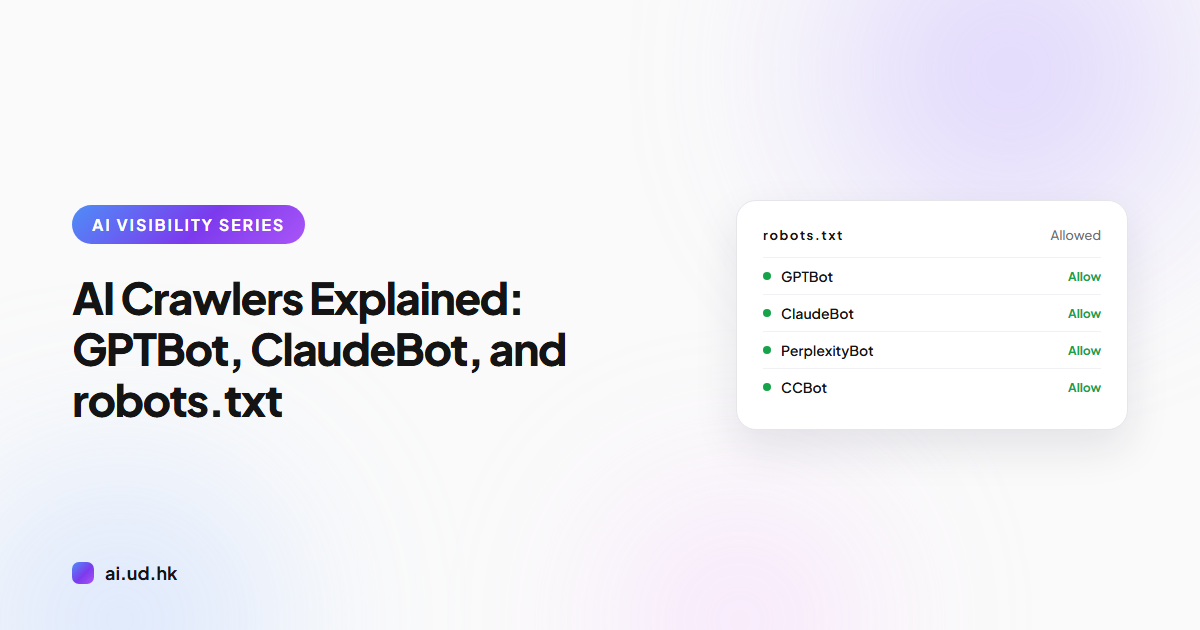
Découvrez GPTBot, ClaudeBot et les autres robots d'indexation d'IA : ce qu'ils collectent, comment les accueillir dans robots.txt et comment repérer les blocages de CDN dans vos journaux serveur.
Les robots d'indexation d'IA sont des programmes automatisés exploités par OpenAI, Anthropic et d'autres entreprises d'IA, qui récupèrent le contenu public de votre site web. Leurs visites poursuivent deux objectifs : collecter des données d'entraînement pour les modèles d'IA et récupérer des pages en temps réel lorsqu'un utilisateur pose une question. Ce guide passe en revue la liste des robots documentés, la manière d'écrire un robots.txt qui les accueille, les moyens de détecter les blocages involontaires et la façon de confirmer leurs visites dans vos journaux serveur.
Les principaux robots d'indexation d'IA : qui visite votre site
Les robots d'indexation d'IA récupèrent des contenus web qui sont soit intégrés aux données d'entraînement des grands modèles de langage, soit cités en temps réel lorsqu'un moteur d'IA répond à une question. Voici les principaux noms recensés dans les documentations publiques :
- GPTBot : exploité par OpenAI, il récupère les contenus web publics pour l'entraînement des modèles.
- ClaudeBot : exploité par Anthropic, il collecte des données d'entraînement pour la famille de modèles Claude.
- PerplexityBot : exploité par Perplexity, il construit l'index qui alimente son moteur de recherche par IA.
- Google-Extended : il s'agit d'un jeton de contrôle robots.txt proposé par Google, pas d'un robot d'indexation. Il détermine si vos contenus peuvent servir à l'entraînement d'IA, tandis que la récupération effective reste assurée par Googlebot.
- CCBot : le robot d'indexation de Common Crawl, qui constitue une archive publique du web. De nombreux modèles d'IA puisent leurs données d'entraînement dans cette archive.
Chaque robot s'identifie dans l'en-tête User-Agent de ses requêtes. C'est par cet en-tête que vous les reconnaissez.
Entraînement ou récupération en direct : deux objectifs, deux conséquences
Les robots d'entraînement versent vos contenus dans les données d'entraînement, qui déterminent ce que sauront les futurs modèles. Si votre marque et votre expertise figurent dans ces données, le modèle aura plus de chances de vous mentionner par la suite en répondant à des questions connexes.
Les robots de récupération en direct vont chercher les pages au moment même où l'utilisateur pose sa question. Le moteur d'IA cite le contenu directement et joint souvent un lien vers la source : l'effet est une exposition immédiate, plus proche de la recherche traditionnelle.
OpenAI illustre bien l'importance de cette distinction. L'entreprise documente trois robots distincts : GPTBot pour l'entraînement des modèles, OAI-SearchBot pour la recherche dans ChatGPT et ChatGPT-User pour la navigation en direct pour le compte d'un utilisateur ; chacun se contrôle séparément dans robots.txt. Bloquer GPTBot ne retire pas votre site de la recherche ChatGPT.
Les conséquences d'un blocage diffèrent selon le type. Bloquer les robots d'entraînement, c'est être durablement absent de ce que les modèles connaissent. Bloquer les robots de récupération, c'est devenir immédiatement invisible dans la recherche par IA : identifiez donc le type auquel vous avez affaire avant de décider.
Écrire un robots.txt qui accueille au lieu de bloquer
La logique par défaut de robots.txt est simple : tout ce qui n'est pas visé par une règle Disallow est autorisé. Pour accueillir explicitement les robots d'indexation d'IA, nommez-les un par un :
User-agent: GPTBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: PerplexityBot
Allow: /
Une directive Allow explicite remplit deux fonctions : elle affiche une position ouverte et elle met ces robots hors de portée d'éventuelles règles Disallow générales. L'erreur la plus fréquente que les sites s'infligent à eux-mêmes consiste à associer User-agent: * à Disallow: /, ce qui ferme la porte à tous les robots d'indexation, ceux des IA compris.
Vous pouvez aussi ajouter un fichier llms.txt à la racine de votre site. llms.txt est un projet de fichier texte qui résume en Markdown les contenus clés de votre site à l'intention des grands modèles de langage ; il complète robots.txt sans le remplacer.
Pare-feu et CDN : les blocages involontaires les plus courants
Un robots.txt accueillant ne sert à rien si les requêtes sont arrêtées au niveau du pare-feu : le robot n'arrive jamais jusqu'à votre contenu. C'est la défaillance la plus fréquente et la plus invisible.
Les fonctions de gestion des bots des WAF et des CDN considèrent fréquemment les robots d'indexation d'IA comme du trafic malveillant et renvoient des erreurs 403 ou des pages CAPTCHA. Certains fournisseurs de CDN activent même le blocage des robots d'IA par défaut : un propriétaire de site peut donc bloquer depuis des mois sans le savoir.
Trois endroits sont à contrôler. Passez en revue les réglages de gestion des bots de votre CDN ou de votre pare-feu, cherchez les règles de blocage qui visent des chaînes User-Agent et vérifiez que la limitation de débit ne prend pas une exploration normale pour une attaque. Si nécessaire, ajoutez les robots d'IA connus à une liste d'autorisation.
Confirmer les visites des robots d'IA dans vos journaux serveur
La méthode la plus directe consiste à rechercher dans les journaux d'accès de votre serveur les chaînes User-Agent des robots, comme GPTBot, ClaudeBot, PerplexityBot et CCBot. Dès que vous trouvez des entrées, vérifiez deux choses.
D'abord, les codes de statut. Un 200 signifie que le contenu a bien été lu, un 403 que la requête a été bloquée et un 404 que le chemin n'existe pas. Un grand nombre de 403 est la preuve directe d'un blocage involontaire.
Ensuite, l'authenticité. Les chaînes User-Agent peuvent être usurpées : certaines entreprises publient donc les plages d'adresses IP officielles de leurs robots, et vous pouvez aussi vérifier la provenance par une résolution DNS inverse. Attention : si un CDN se trouve devant votre site, les requêtes qu'il bloque n'atteignent jamais les journaux du serveur d'origine ; consultez alors les journaux ou le tableau de bord du CDN.
FAQ
Qu'est-ce que GPTBot ?
GPTBot est le robot d'indexation web d'OpenAI. Il récupère des contenus web publics pour l'entraînement des modèles d'IA et se contrôle dans robots.txt.
Bloquer GPTBot retire-t-il mon site de la recherche ChatGPT ?
Non. La recherche ChatGPT s'appuie sur OAI-SearchBot, un robot distinct doté de ses propres contrôles dans robots.txt. GPTBot ne régit que les données d'entraînement.
Bloquer Google-Extended nuit-il à mon classement dans Google Search ?
Non. Google-Extended ne régit que l'autorisation d'utilisation pour l'entraînement d'IA et fonctionne indépendamment de l'indexation et du classement assurés par Googlebot.
Qu'est-ce que llms.txt ?
llms.txt est un projet de fichier texte placé à la racine d'un site. Il résume en Markdown les contenus clés du site pour que les modèles d'IA puissent les lire.
Comment savoir si des robots d'IA ont visité mon site web ?
Recherchez dans les journaux d'accès de votre serveur les chaînes User-Agent telles que GPTBot et ClaudeBot, puis vérifiez si les codes de statut sont bien des 200.
Vérifiez si votre site est ouvert ou fermé aux IA
À ce stade, vous voulez probablement savoir où en est votre propre site : robots.txt bloque-t-il par accident et les robots d'indexation d'IA peuvent-ils réellement lire votre contenu ? L'AEO Auditor gratuit d'UDomain (ai.ud.hk/aeo-auditor) contrôle les réglages de visibilité IA de votre site : il suffit de saisir une URL pour obtenir les résultats. Ici, AEO signifie Answer Engine Optimization, c'est-à-dire l'art de rendre un contenu facile à citer pour les moteurs de recherche par IA. Cela n'a rien à voir avec le programme douanier Authorized Economic Operator ni avec le symbole boursier homonyme.
À lire aussi
Envie de savoir si votre site est visible sur l’IA ?
Lancez une analyse gratuite de 30 secondes et voyez votre score et vos recommandations.
Analyse gratuite