教學
AI 爬蟲完整指南:GPTBot、ClaudeBot 來你網站做甚麼
認識 GPTBot、ClaudeBot 等主流 AI 爬蟲:抓甚麼、robots.txt 怎樣寫才算歡迎、CDN 誤封與伺服器日誌核實方法。
AI 爬蟲是 OpenAI、Anthropic 等公司的自動程式,會抓取你網站的公開內容,用途分為模型訓練與即時檢索兩類。本文帶你認識主流爬蟲名單、寫好 robots.txt、排查誤封,並在伺服器日誌確認它們來過。
主流 AI 爬蟲名單:誰在爬你的網站
AI 爬蟲是 AI 公司用來抓取網頁內容的自動程式,抓到的內容會用於訓練大型語言模型,或在用戶提問時作即時檢索與引用。以下是公開文件列明的主流名單:
- GPTBot:OpenAI 旗下,抓取公開網頁內容用於模型訓練。
- ClaudeBot:Anthropic 旗下,為 Claude 系列模型收集訓練數據。
- PerplexityBot:Perplexity 旗下,為其 AI 搜尋引擎建立索引。
- Google-Extended:Google 的 robots.txt 控制項,決定內容能否用於 AI 訓練,實際抓取仍由 Googlebot 執行。
- CCBot:Common Crawl 的爬蟲,建立公開網頁存檔,不少 AI 模型的訓練數據都取自這個存檔。
每個爬蟲都會在請求的 User-Agent 標頭表明身份,這正是你辨認它們的入口。
訓練與即時檢索:兩類用途,兩種後果
訓練型爬蟲把內容收進訓練數據,影響的是未來模型「知道甚麼」。你的品牌與專業內容若在訓練數據中出現,模型日後回答相關問題時更有機會提及你。
即時檢索型爬蟲在用戶提問當下抓取網頁,AI 引擎會直接引用內容,並經常附上來源連結。這類抓取帶來的是即時曝光,效果較接近傳統搜尋。
封鎖兩類爬蟲的後果不同:封訓練型是長期缺席,封檢索型是即時隱形。決定開放或封鎖之前,先分清楚對象屬於哪一類。
robots.txt 怎樣寫才是歡迎而不是封鎖
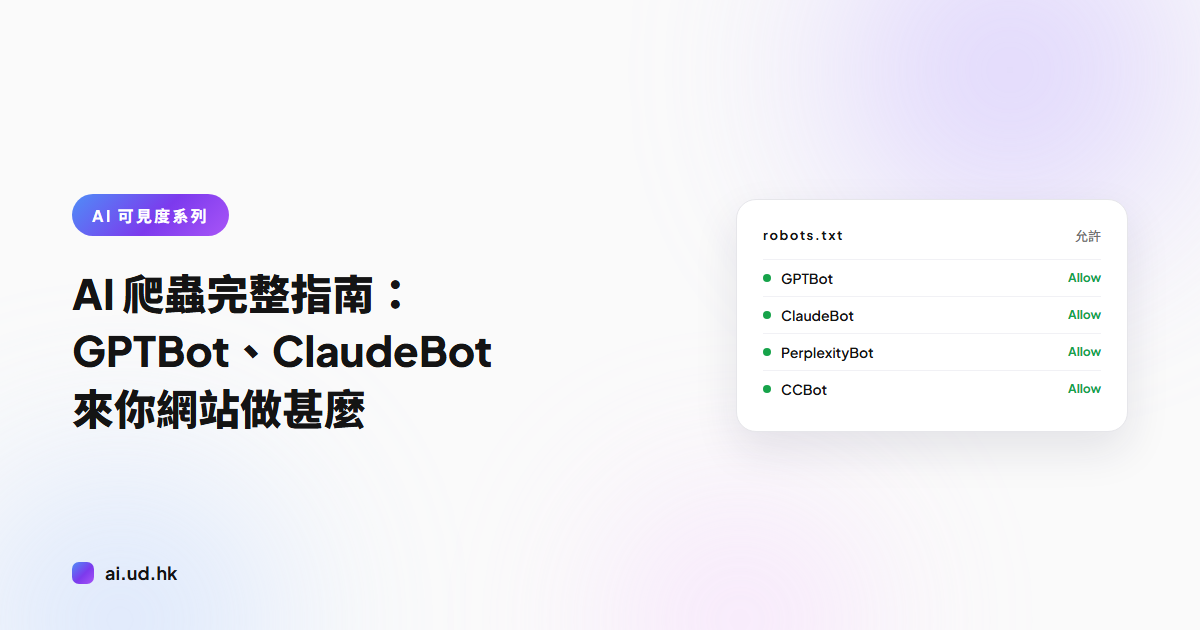
robots.txt 的預設邏輯是:沒有寫 Disallow 就等於允許。想明確歡迎 AI 爬蟲,可以逐一列名:
User-agent: GPTBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: PerplexityBot
Allow: /
明確寫 Allow 有兩個作用:一是宣示開放立場,二是避免這些爬蟲被概括性的 Disallow 規則掃到。最常見的自我封鎖寫法是 User-agent: * 配 Disallow: /,這會把所有爬蟲連同 AI 爬蟲一併拒諸門外。
另外可以在網站根目錄加一個 llms.txt。llms.txt 是一項純文字檔案建議規範,用 Markdown 整理網站重點內容給大型語言模型讀,與 robots.txt 互補而非取代。
防火牆與 CDN 的常見誤傷
robots.txt 寫得再歡迎,如果請求在防火牆一層已被擋下,爬蟲根本讀不到你的內容。這是最常見也最隱蔽的問題。
WAF 與 CDN 的機械人管理功能,經常把 AI 爬蟲當成惡意流量,傳回 403 錯誤或人機驗證頁。部分 CDN 服務商更把封鎖 AI 爬蟲列為預設選項,網站管理員未必知道自己一直在擋。
排查方向有三個:檢查 CDN 或防火牆的機械人管理設定,查看有沒有針對 User-Agent 的封鎖規則,並確認速率限制不會把正常抓取當成攻擊。有需要時,把已知 AI 爬蟲列入白名單。
如何從伺服器日誌確認 AI 爬蟲來過
最直接的方法是在伺服器存取日誌搜尋爬蟲的 User-Agent 字串,例如 GPTBot、ClaudeBot、PerplexityBot、CCBot。找到紀錄後,再看兩件事。
第一是狀態碼:200 代表成功讀取,403 代表被擋,404 代表路徑不存在。大量 403 就是誤封的直接證據。
第二是真偽:User-Agent 可以偽冒,部分公司有公開官方爬蟲的 IP 範圍供核對,也可以用反向 DNS 查證來源。另外要注意,若網站前面有 CDN,被 CDN 擋下的請求不會出現在來源伺服器日誌,要到 CDN 的日誌或分析面板查看。
常見問題
GPTBot 是甚麼?
GPTBot 是 OpenAI 的網頁爬蟲,抓取公開網頁內容用於 AI 模型訓練,可在 robots.txt 控制。
封鎖 GPTBot 會令我的網站從 ChatGPT 搜尋中消失嗎?
不會。ChatGPT 搜尋依賴 OAI-SearchBot,這是另一個有獨立 robots.txt 控制規則的爬蟲。GPTBot 只負責訓練數據。
封鎖 Google-Extended 會影響 Google 搜尋排名嗎?
不會。Google-Extended 只管 AI 訓練授權,與 Googlebot 的搜尋索引和排名互相獨立。
llms.txt 是甚麼?
llms.txt 是網站根目錄的純文字檔案建議規範,用 Markdown 整理網站重點供 AI 模型讀取。
怎樣確認 AI 爬蟲有沒有來過我的網站?
在伺服器存取日誌搜尋 GPTBot、ClaudeBot 等 User-Agent 字串,並查看狀態碼是否為 200。
檢查你的網站對 AI 是開門還是關門
讀到這裏,你大概想知道自己網站的現況:robots.txt 有沒有誤封,AI 爬蟲能不能順利讀取內容。UDomain 的免費工具 AEO Auditor(ai.ud.hk/aeo-auditor)可以替你檢測網站的 AI 可見度設定,輸入網址就能看到結果。這裏的 AEO 指答案引擎優化(Answer Engine Optimization),與海關的認可經濟營運商計劃無關。